 Desarrollo y datos
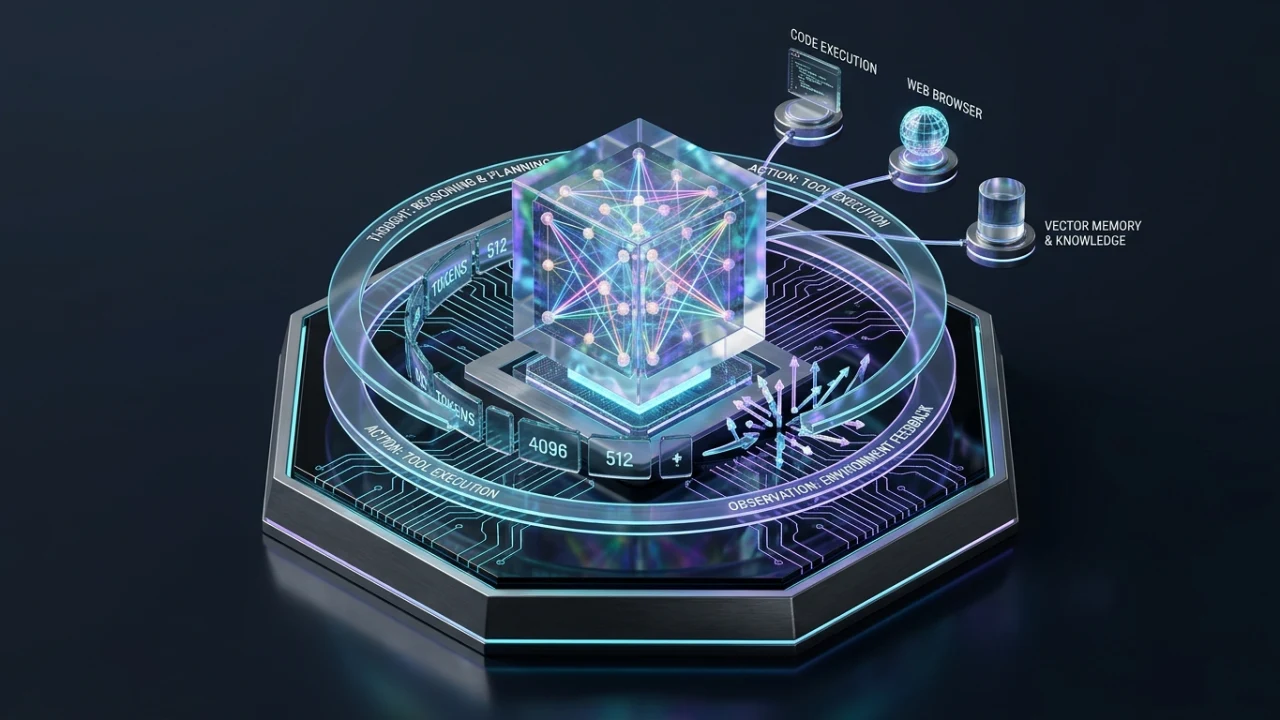
Anatomía de la IA y agentes: simulador visual interactivo
Tokens en tiempo real, constelación de embeddings, Self-Attention y bucle agéntico ReAct • Desarrollo
Comprueba si una URL concreta o patrón de ruta está permitida o bloqueada según las reglas actuales de tu robots.txt, aplicando la regla de precedencia por longitud máxima coincidente y comodines (* y $).
El archivo robots.txt es un fichero de texto plano ubicado en la raíz del servidor web (por ejemplo, https://dominio.com/robots.txt) que indica a los motores de búsqueda y rastreadores web qué rutas pueden o no solicitar. En 2022, el IETF publicó el estándar formal RFC 9309, que formaliza el protocolo de exclusión de robots, especificando la sintaxis oficial, el orden de precedencia por longitud de regla más específica y el manejo de comodines (* y $).
Disallow en robots.txt impide que los motores de búsqueda rastreen y descarguen la página, pero NO garantiza que la URL desaparezca de los resultados si otros sitios la enlazan (Google puede indexarla mostrando solo la URL sin snippet). Si deseas evitar por completo que una página aparezca en los resultados de búsqueda, debes permitir su rastreo y añadir la etiqueta <meta name="robots" content="noindex"> o la cabecera HTTP X-Robots-Tag: noindex.
Según la especificación formal RFC 9309, cuando una URL coincide con varias directivas de un mismo User-agent, prevalece la directiva con el patrón coincidente más largo (más específico en número de caracteres). Por ejemplo, si tienes "Disallow: /tienda/" (9 caracteres) y "Allow: /tienda/ofertas" (15 caracteres), la URL /tienda/ofertas/camisa estará permitida porque la regla Allow es más larga. En caso de empate exacto de longitud, la directiva Allow tiene prioridad sobre Disallow.
Los principales creadores de modelos fundacionales de inteligencia artificial han publicado User-agents oficiales para su rastreo de datos. Declarando directivas específicas de "Disallow: /" para User-agents como GPTBot (OpenAI), CCBot (Common Crawl), Google-Extended (Gemini), ClaudeBot (Anthropic), Bytespider (ByteDance) y PerplexityBot, puedes impedir que tus contenidos se utilicen para entrenamiento sin afectar a tu indexación orgánica en Google o Bing.
Debe situarse estrictamente en la raíz absoluta del dominio o subdominio y en minúsculas (https://ejemplo.com/robots.txt). Los buscadores no consultan archivos robots.txt en subdirectorios como https://ejemplo.com/blog/robots.txt. Asimismo, cada subdominio (por ejemplo, tienda.ejemplo.com) requiere su propio archivo robots.txt independiente.